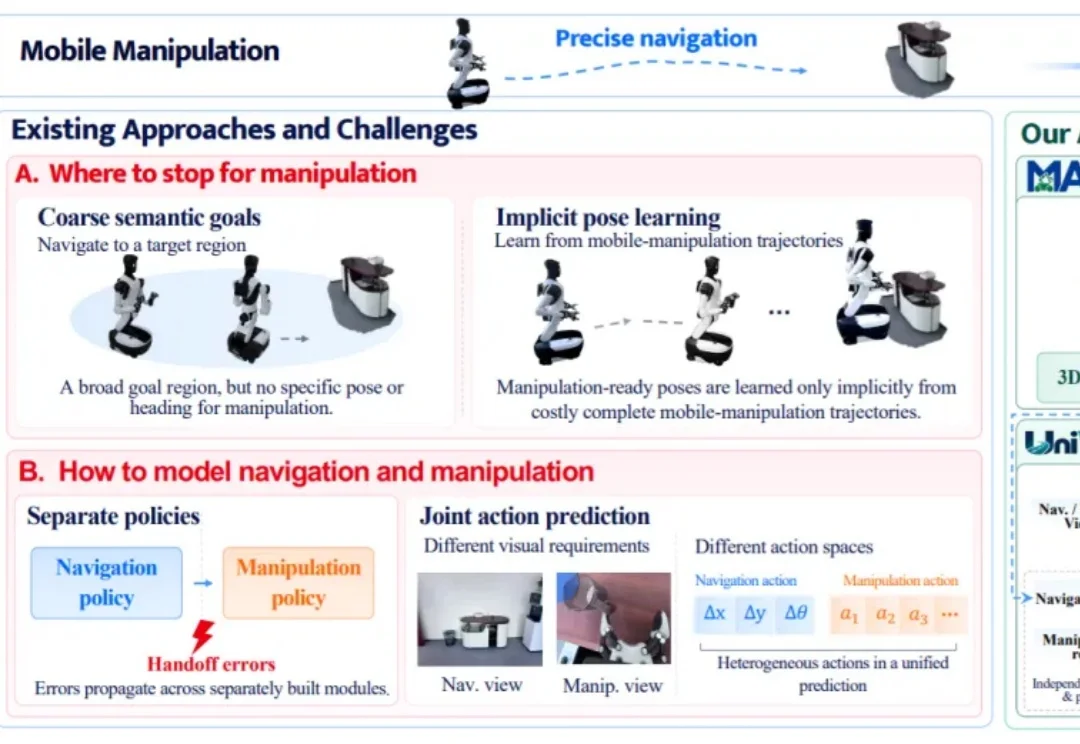
24项真机硬碰硬!不靠大规模机器人预训练,Fysiverse-UniWAM拿下导航、移动操作双第一
24项真机硬碰硬!不靠大规模机器人预训练,Fysiverse-UniWAM拿下导航、移动操作双第一机器人终于不只是知道往哪走,还知道该在哪里停、以什么方向面对目标,甚至停稳之后,就能直接上手干活。
来自主题: AI技术研报
9762 点击 2026-11-02 10:58

 搜索
机器人终于不只是知道往哪走,还知道该在哪里停、以什么方向面对目标,甚至停稳之后,就能直接上手干活。
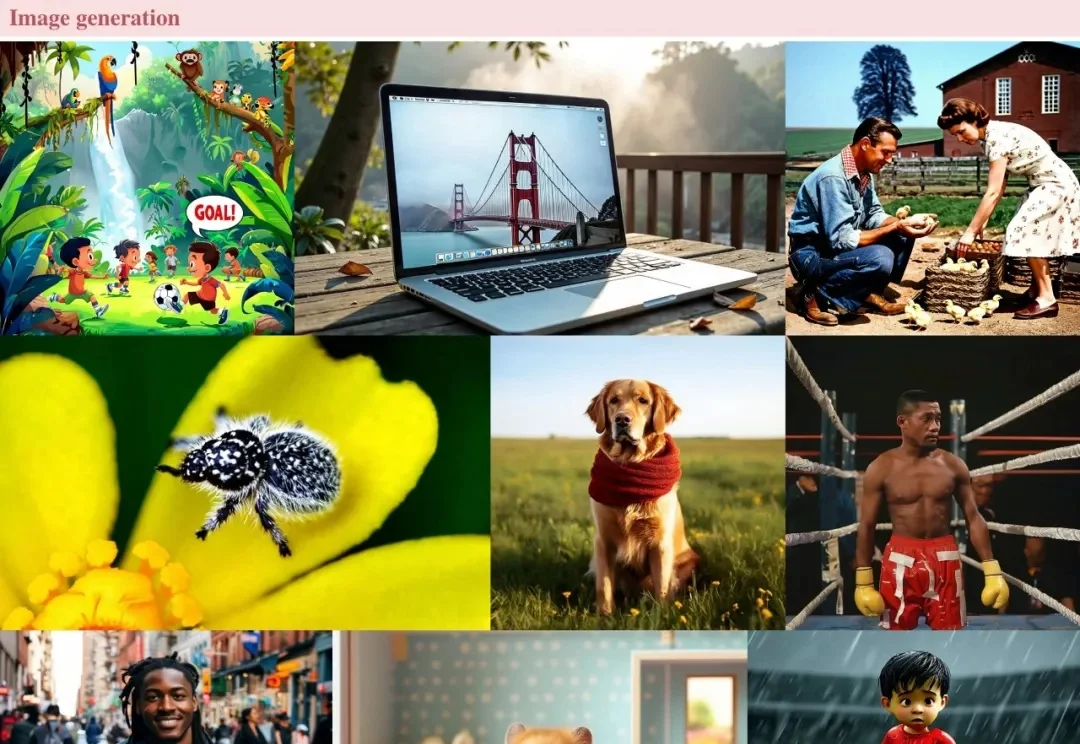
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
具身智能不缺钱,也不缺演示,真正稀缺的是一条能复现的 Scaling 曲线。去年 11月,北美的 Generalist 发布 GEN-0,称首次在机器人身上观察到了这条曲线:预训练数据和算力越多,模型在下游任务上的表现就越稳定、可预测地提升。支撑这条曲线的,是超过 27 万小时的真实世界操作数据,和每周新增上万小时的采集速度。对绝大多数公司来说,曲线已经有人跑出来了,燃料却还没有。
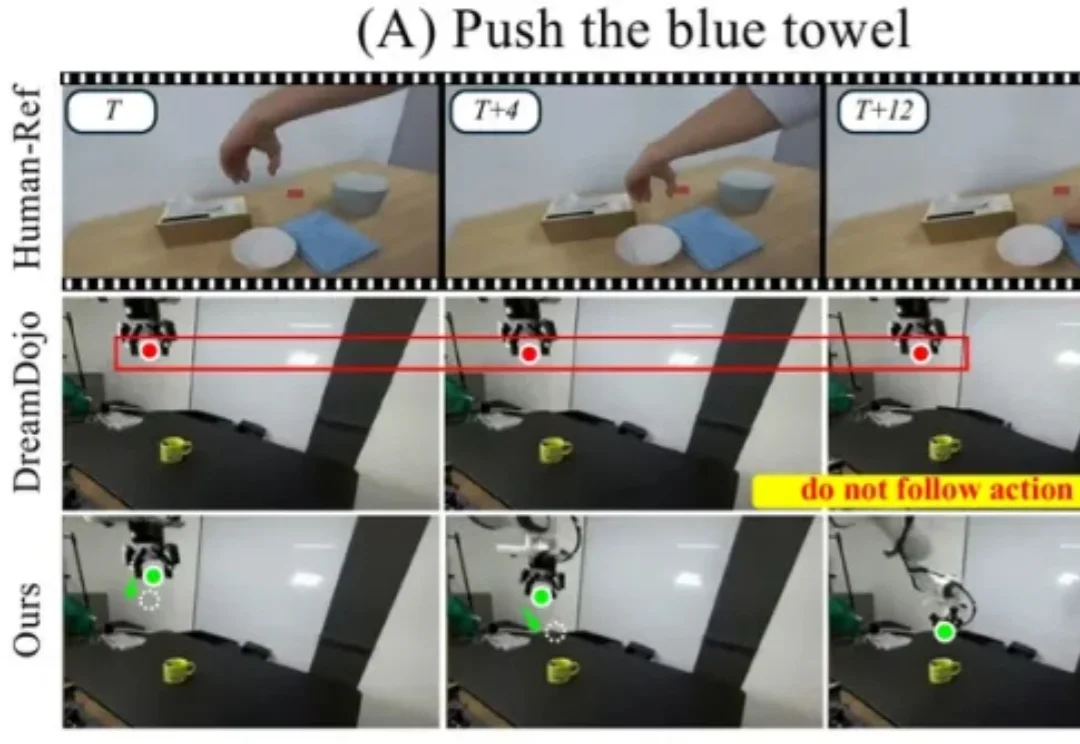
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
训练大模型,能不能不用反向传播?
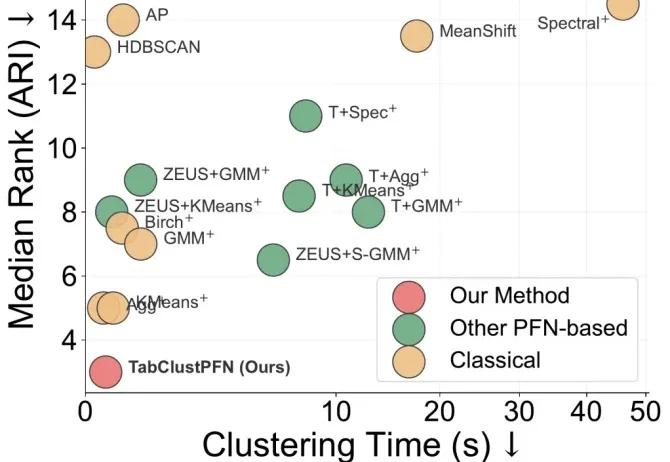
拿到一张没有标签的表格,能不能直接找出其中的群体,还知道模型对 “分几组” 有多大把握?TabClustPFN 尝试用预训练后的单次前向推断,缩短从数据到分组结果的距离。
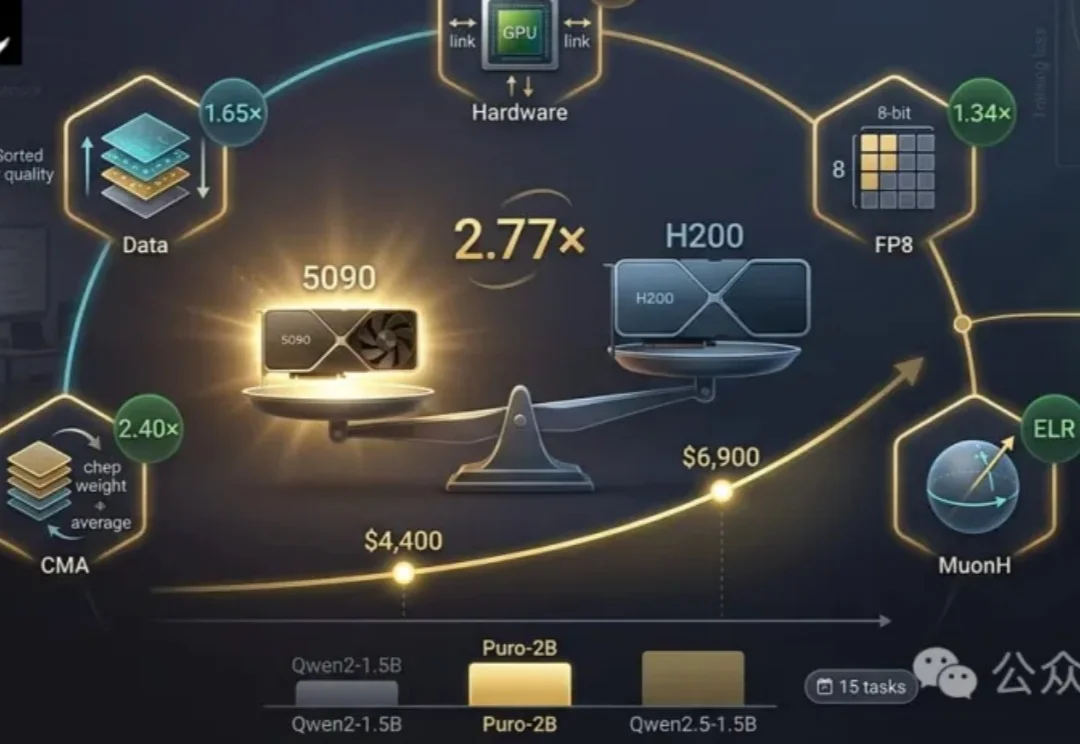
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
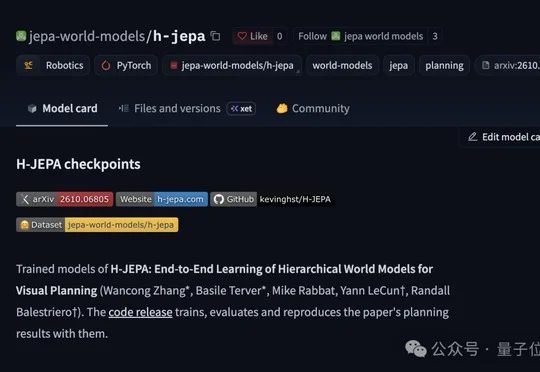
LeCun创办的AMI联合纽约大学、巴黎INRIA和布朗大学推出分层世界模型H-JEPA并开源代码及预训练权重,其在Visual AntMaze任务中以更少规划计算取得更高成功率。
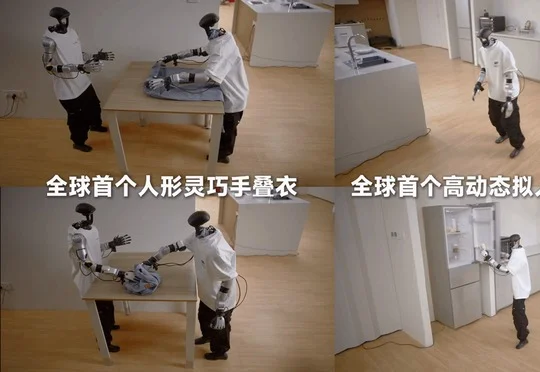
西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
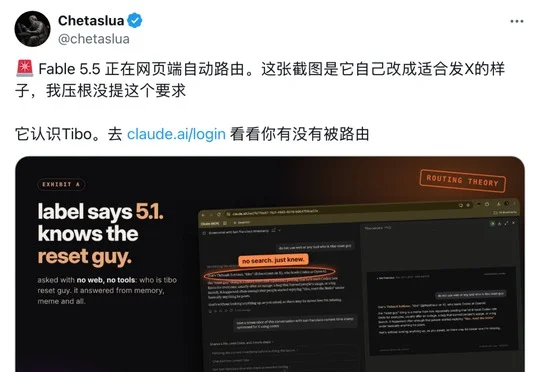
开发者发现Claude网页端悄然灰度Anthropic下一代旗舰Fable 5.5,全网首测显示其在图像绘制与3D动画生成等任务上实现断层式跃升,爆料称得益于全新预训练,Claude全系模型换代在即。