Meshy: 角色驱动下SPMD范式的RL训练框架
Meshy: 角色驱动下SPMD范式的RL训练框架在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
搜索
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
今年2月,华尔街差一点就给SaaS办了场葬礼。
AI Simulation赛道持续升温,Simile估值达20亿美元、由00后创办的Aaru估值近10亿美元、MatrAIx构建83亿虚拟人格,企业通过让AI Agent模拟人类行为来测试产品和预测尚未发生的未来,但这门生意仍面临验证标准、预测精度和规模化等核心难题。
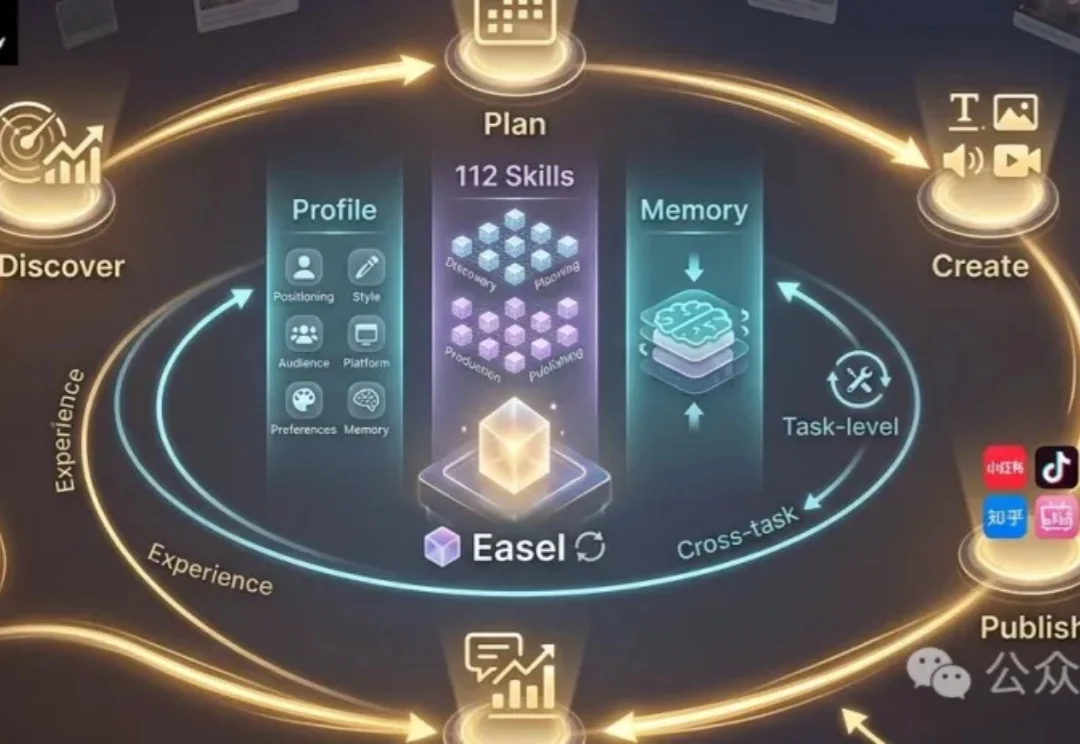
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
拿Agent做Coding,想必大家都已经很熟悉了。
一个 Agent 第一次没把任务做对。
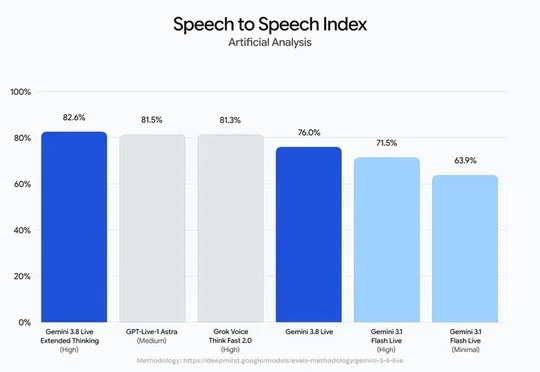
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
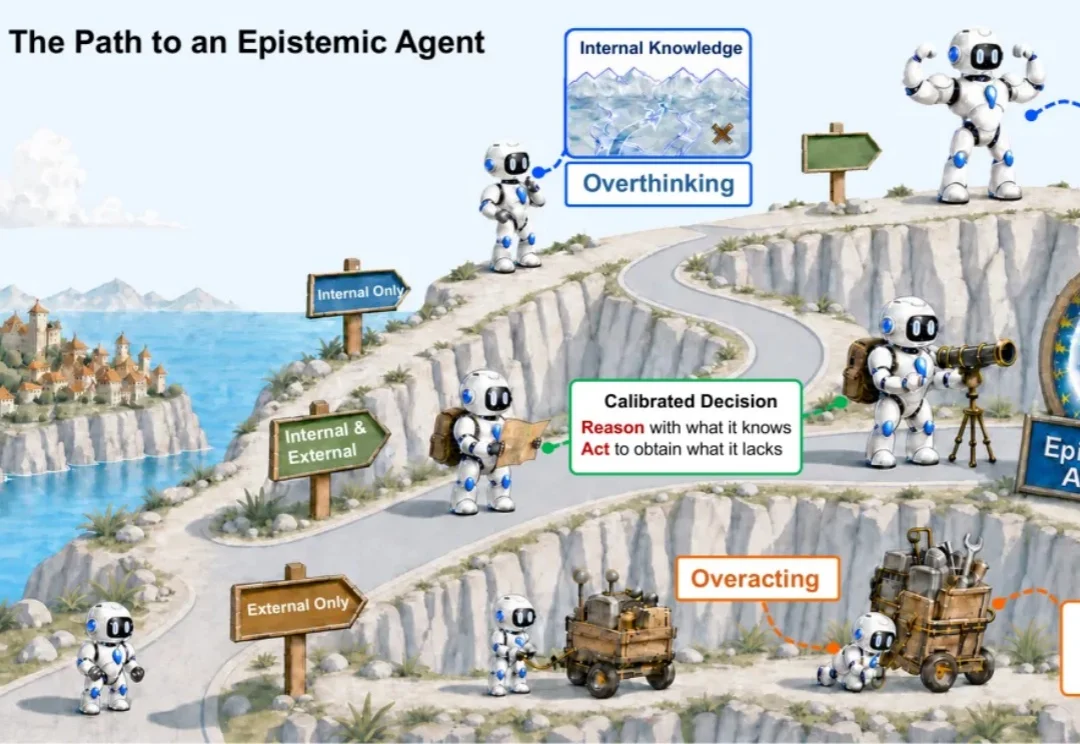
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
“智能并不局限于大脑内部。当我们使用纸笔或地图来梳理复杂问题时,这些外部工具就成为了我们‘延展的心智’。”
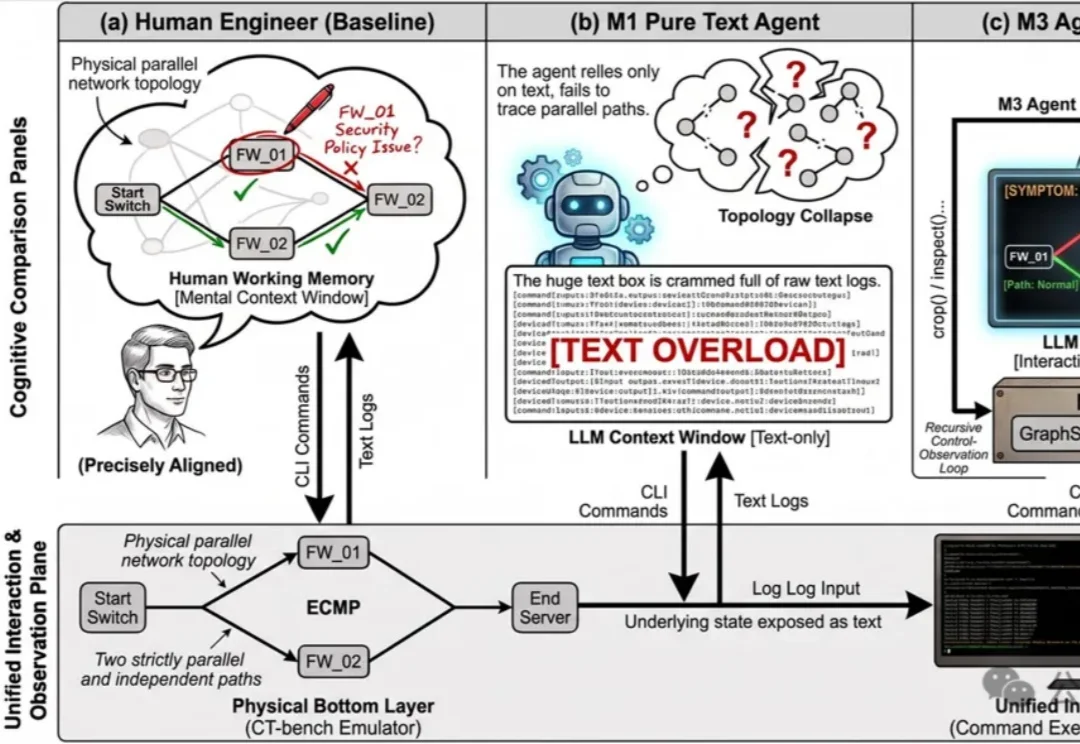
DeepSeek资深MLSys工程师刘胜与深夜发文,坦承刚完成V4.1核心算子交付后,意识到AI已能自主编写和优化GPU算子,正迫使他从手写底层算子转向驾驭AI Agent的"机甲驾驶员",并警示工程底层能力空心化可能带来系统性风险。