GLM-5.3-FlashX 上线:200 tokens/s
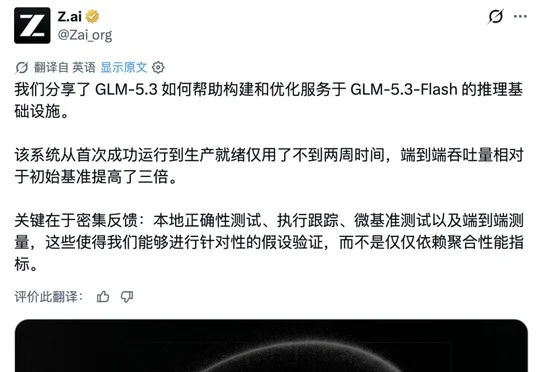
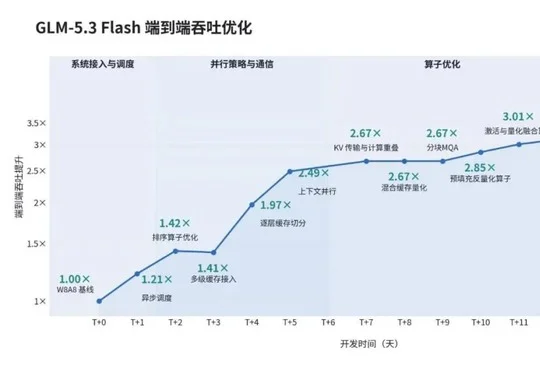
GLM-5.3-FlashX 上线:200 tokens/s智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
搜索
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。
这几天 ox-alpha 用爽了吧...正如很多人猜的那样,这个模型来自智谱,正式名称为 glm-5.3-flash,支持多模态,但很多人没猜到的是:这个乱杀的模型只有 321B,且与 glm-5.3 不同,是完全的新架构
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分
就在刚刚,智谱发布了其最新一代旗舰模型GLM-5.3,并宣布模型将在两周内开源。这是一个拥有7430亿个参数的模型,和此前的GLM模型一样主打编程。在多项主流基准测试中,GLM-5.3位居所有已开源或即将开源模型中的第一;其在编程与智能体任务上的能力,已逼近Claude Fable 5、GPT-5.6 Sol等海外顶尖模型。
最近,清华教授、智谱灵魂人物唐杰聊得有点high。