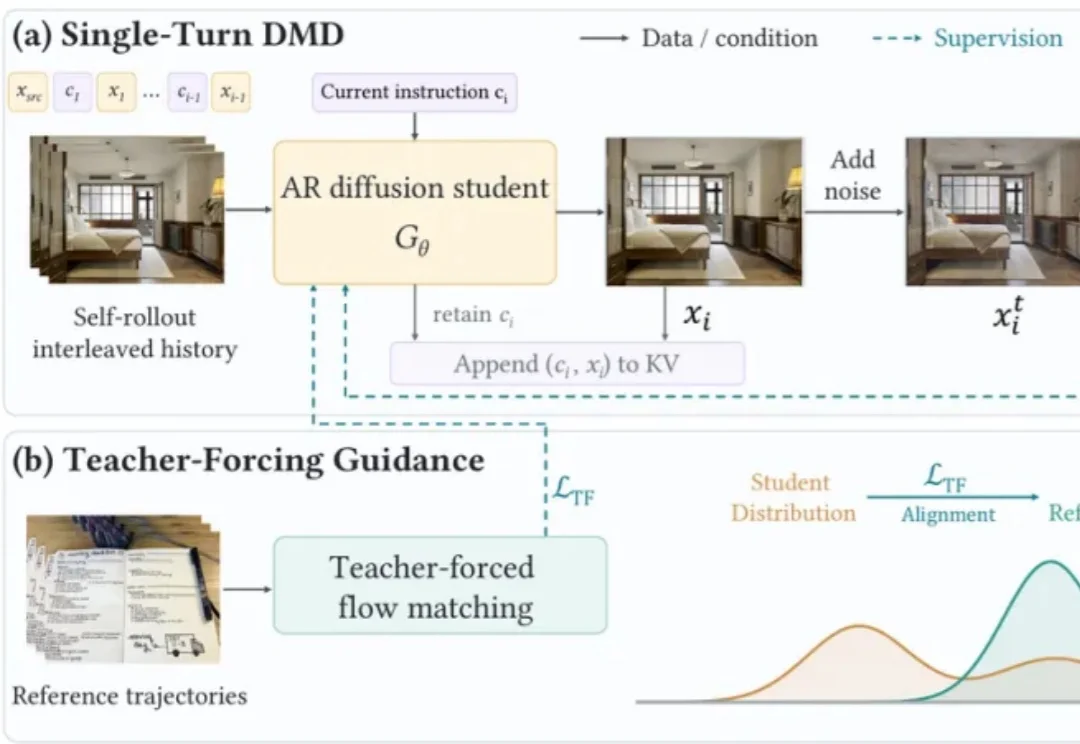
多轮图像编辑如何保住画质与细节?商汤、港科MMLab等联合提出MT Forcing
多轮图像编辑如何保住画质与细节?商汤、港科MMLab等联合提出MT Forcing多轮图像编辑允许用户通过连续指令,逐步调整同一张图片中的物体、外观与场景。随着图像生成进入交互创作,用户需要根据中间结果继续修改,模型也需要在完成新要求的同时,保留此前已经确认的内容。
来自主题: AI技术研报
5371 点击 2026-11-03 16:40

 搜索
多轮图像编辑允许用户通过连续指令,逐步调整同一张图片中的物体、外观与场景。随着图像生成进入交互创作,用户需要根据中间结果继续修改,模型也需要在完成新要求的同时,保留此前已经确认的内容。
过去几年,神经网络接连改写了一个又一个领域:图像生成有了 Stable Diffusion,视频生成已经能做到以假乱真,就连 3D 渲染也出现了 RenderFormer 这样的纯神经网络方法。但在高保真物理仿真上,神经网络始终没能交出令人满意的答卷,游戏、动画和机器人领域至今仍依赖需要手动调参、难以求梯度的传统求解器。
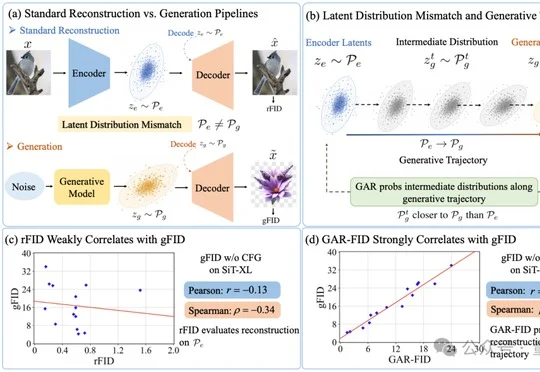
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
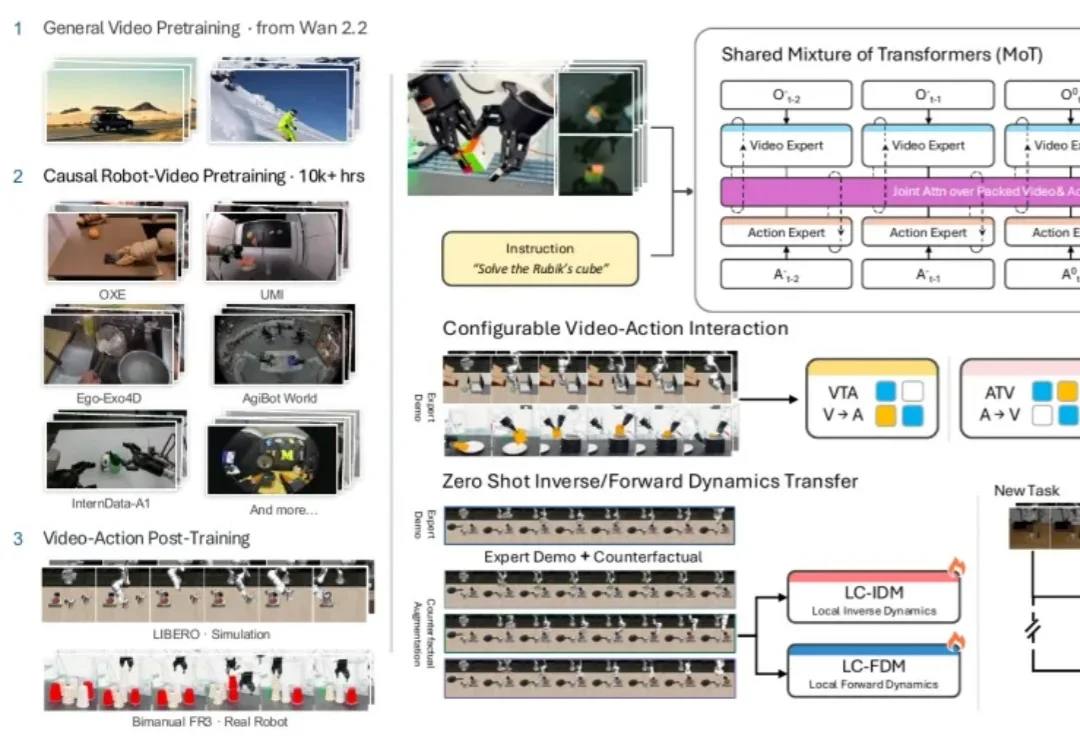
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
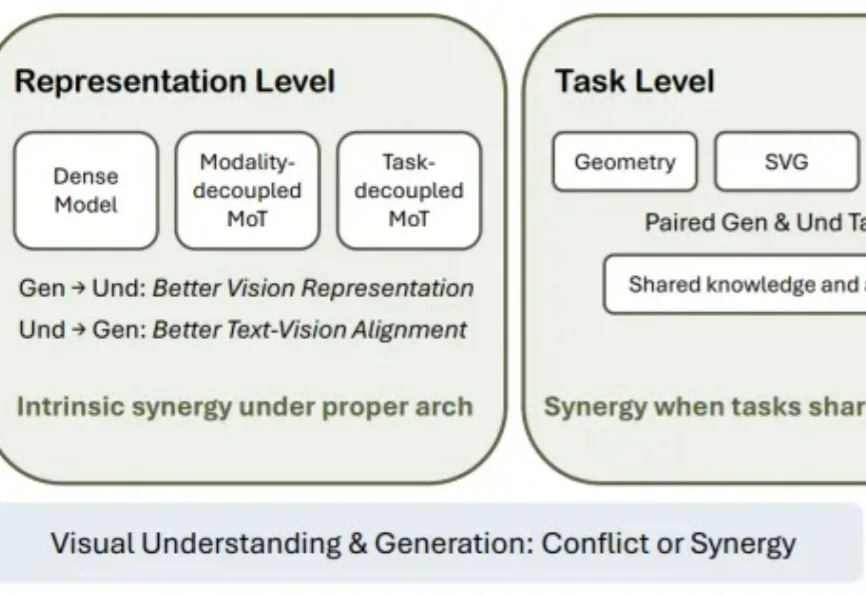
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
OpenAI发布新一代图像生成模型ChatGPT Images 2.5,在图片细节质量、生成速度、编辑精度及多轮修改一致性上有所提升,并新增Sketch手绘参考、创作模板和图片评论编辑等功能。
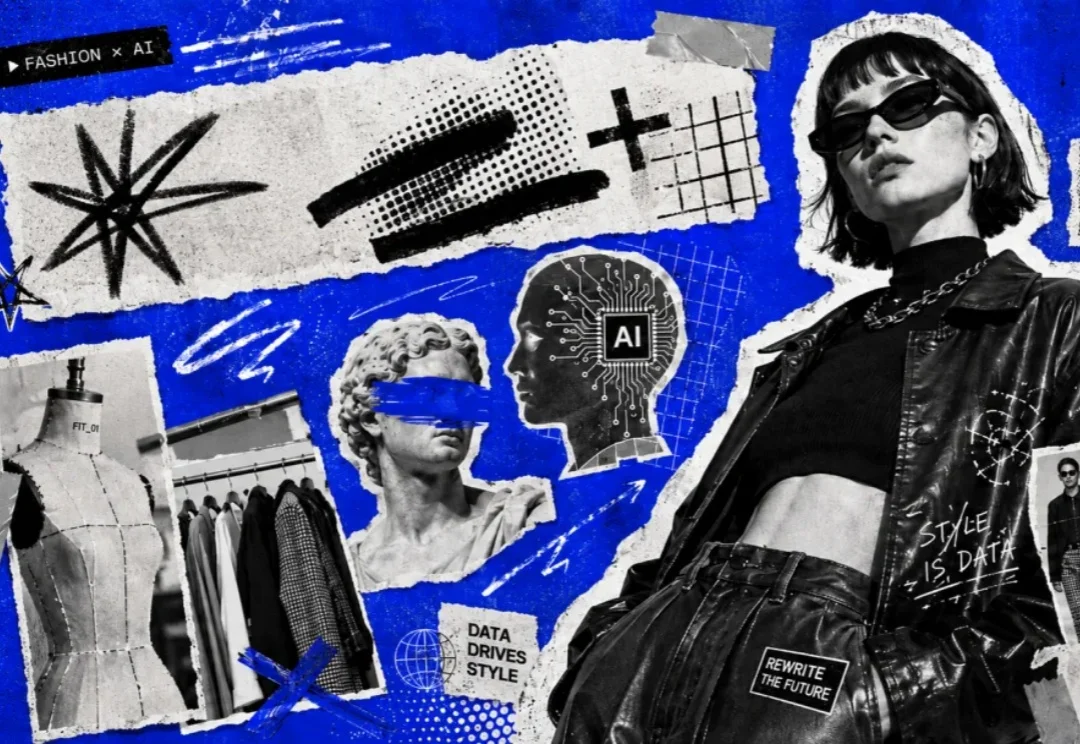
过去两年,AI生图的参数量与清晰度完成了指数级跨越,但真正面向服装行业却依然面临一个极其尴尬的悖论——当GPT、Gemini等顶尖大模型在通用图像生成上大放异彩时,落地到服装产业的深水区,依然满屏是令人出戏的AI味。通用的SOTA模型做得到了“逼真”,却依然做不好“商业”。

图像生成模型正从「会创作」转向「可操作」。

这两天,Arena 平台上突然出现一款神秘的图像生成模型,代号「mona-lisa-1」。有人让该模型「生成一张你的创造者的图片」,模型点名 OpenAI 和奥特曼。且有网友用 OpenAI 验证工具检测生成图片后,确认图片中带有 OpenAI 的 SynthID 水印。

近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。