混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要
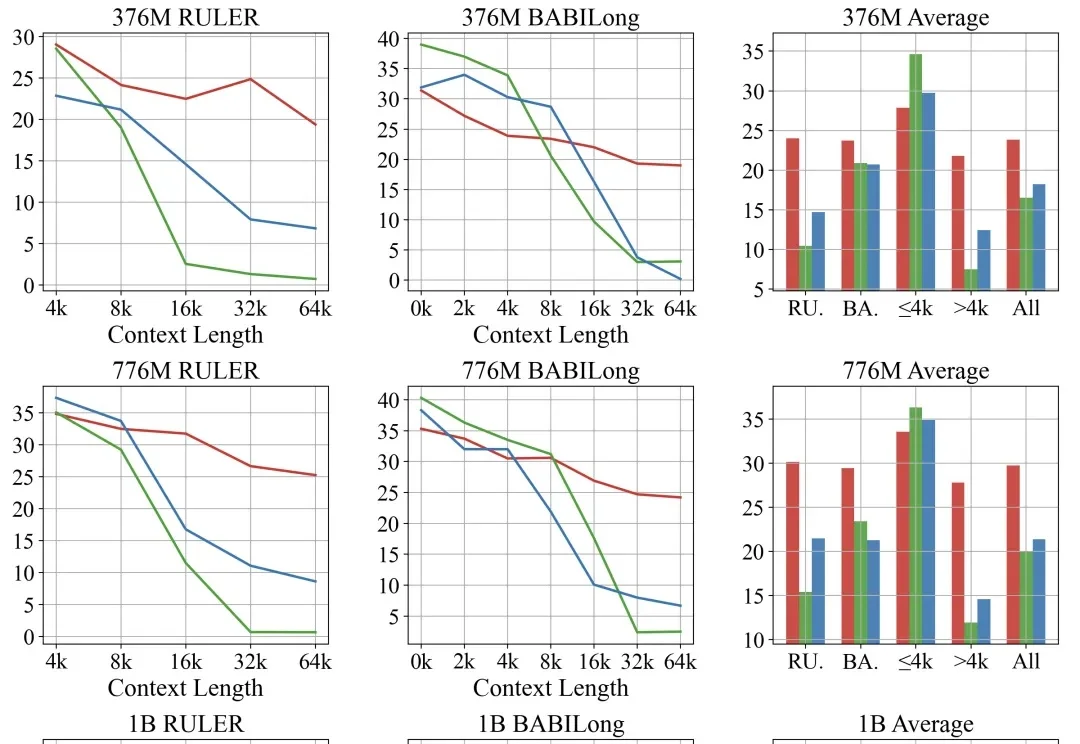
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
搜索
长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。
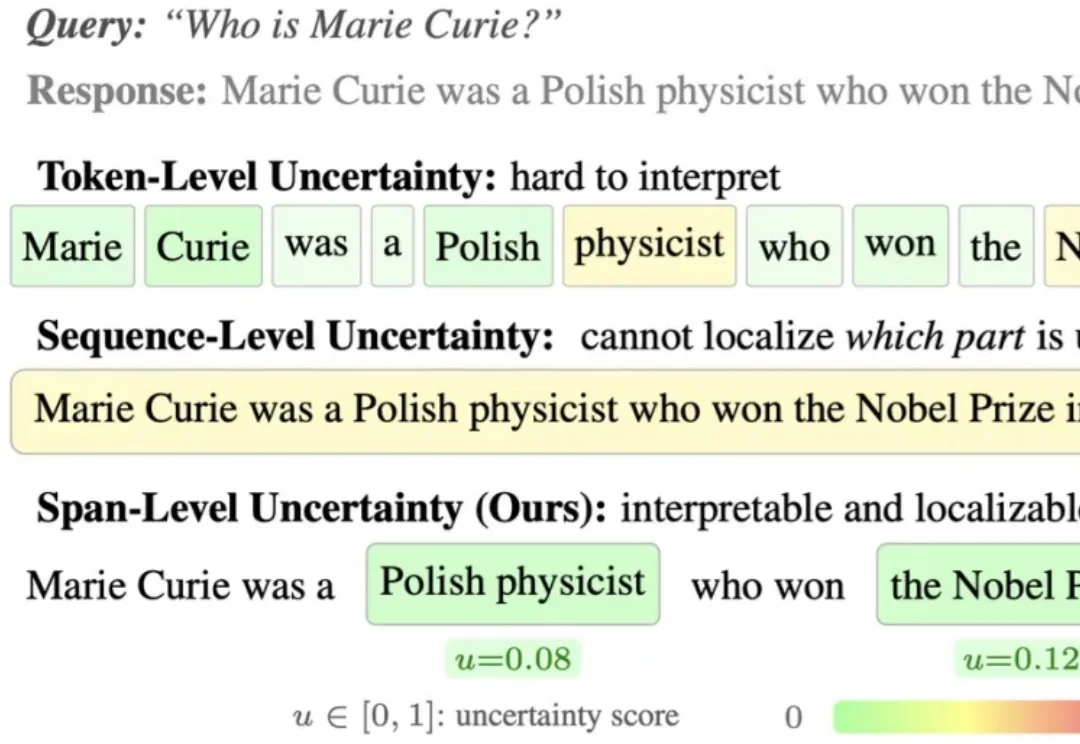
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
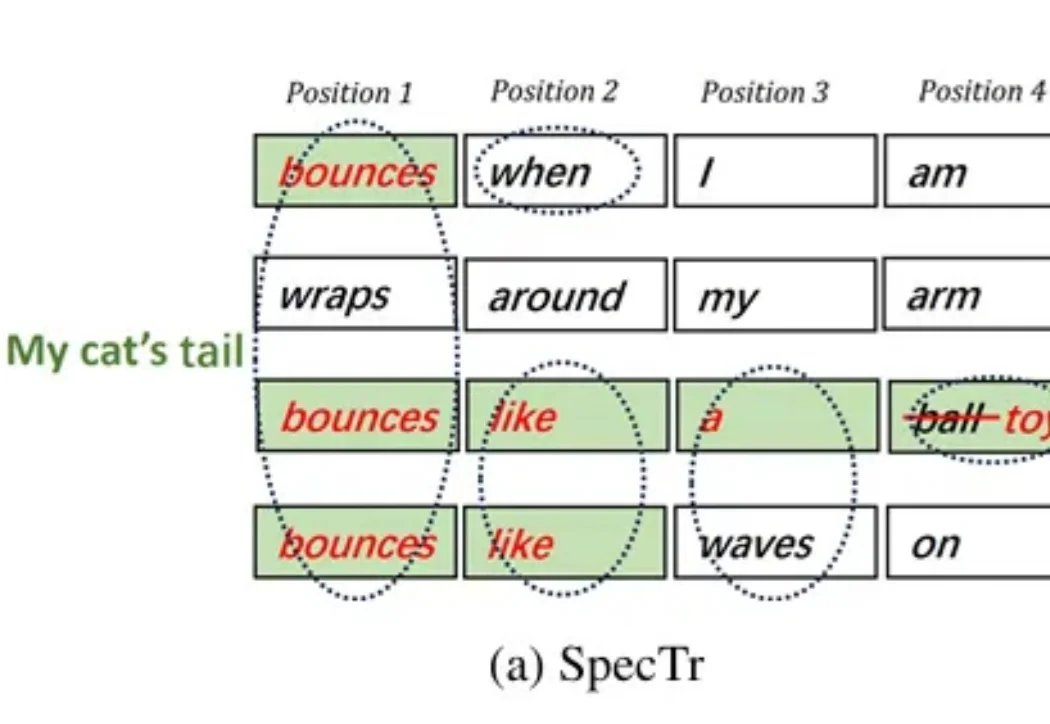
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
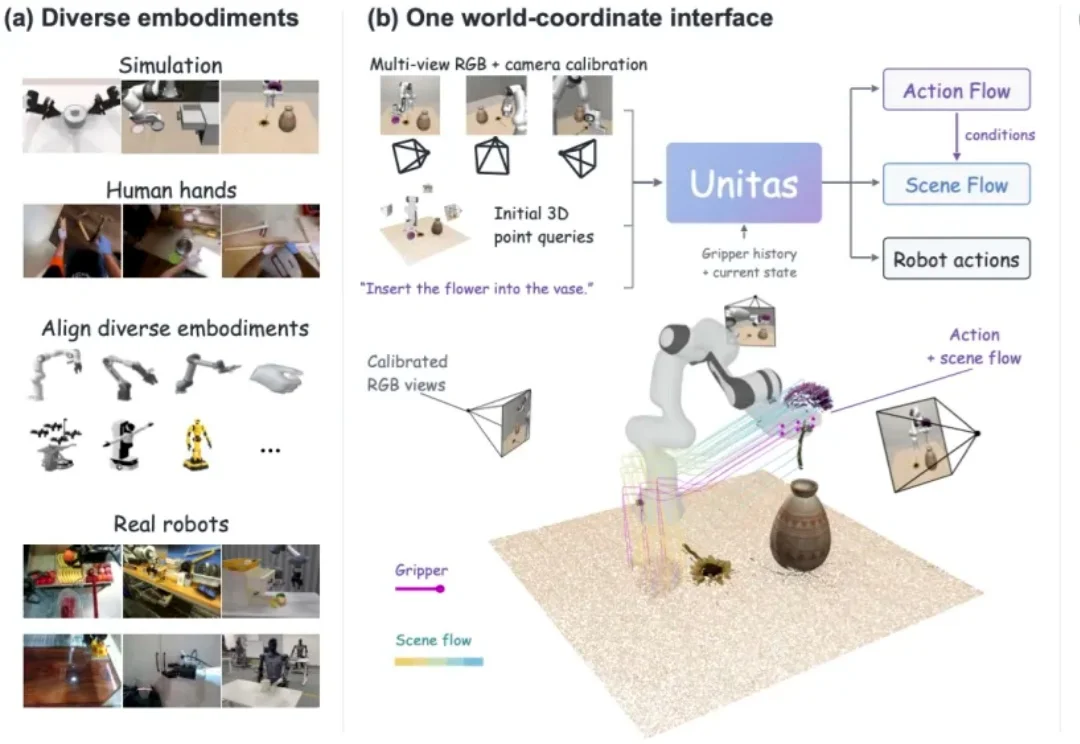
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?
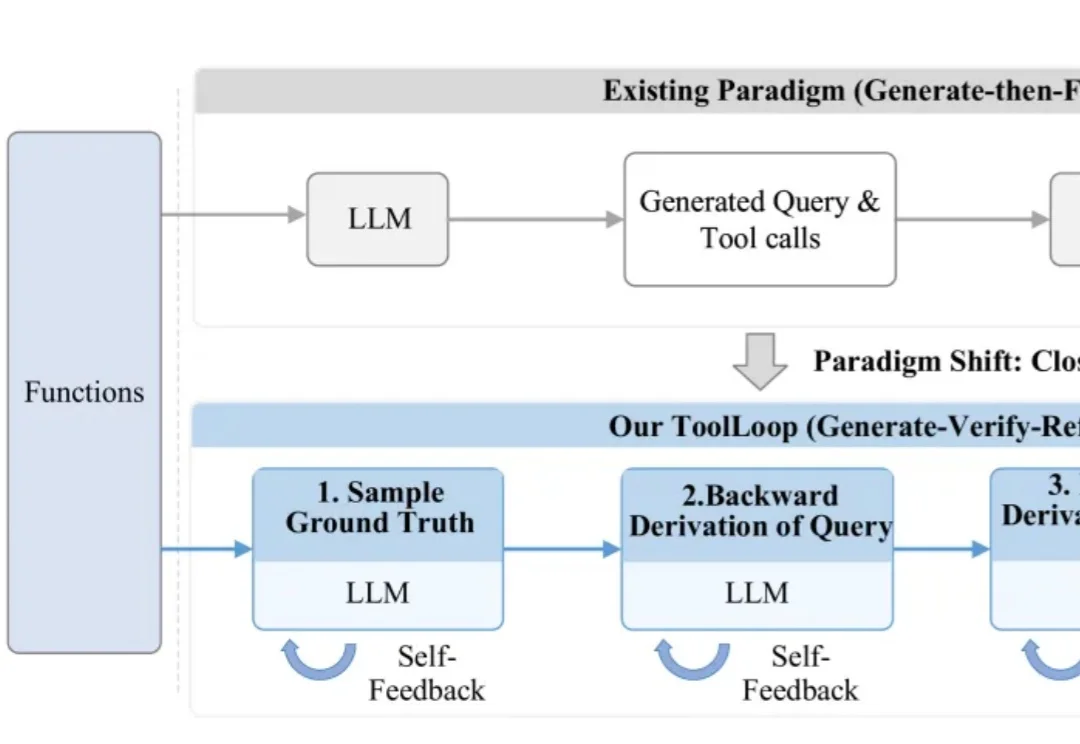
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
TypeSafe AI 开发的非大语言模型 Jev 正式向所有用户开放并赠送约 1.2 亿 Token 额度,该模型由前 OpenAI 研究员 Diogo Almeida 创立,可输出类型化结构决策,速度较同类大语言模型快 20 至 200 倍。
大语言模型智能体正越来越多地进入长期陪伴聊天这类场景 —— 不再答完一个问题就走,而是和用户处成一段长久的关系。
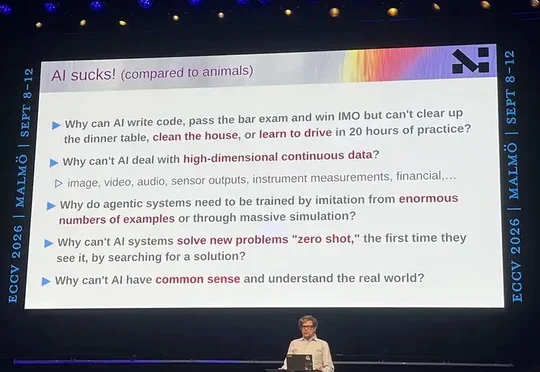
图灵奖得主Yann LeCun在ECCV 2026发表Keynote演讲,论证"预测像素"是伪命题,阐述JEPA在抽象表征空间预测世界的机制,并建议研究者放弃生成式模型与大语言模型,转向联合嵌入架构与世界模型以实现人类水平智能。
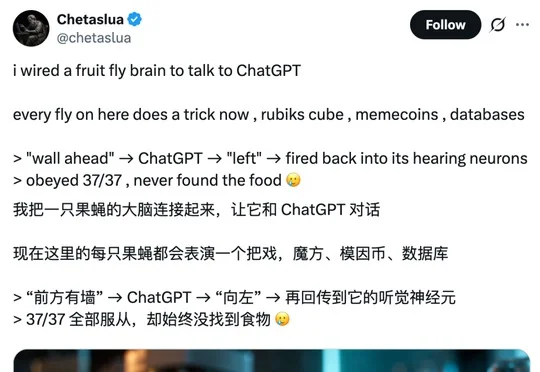
开发者chetaslua在MacBook上用NumPy和MaleCNS连接组数据模拟了13.8万个神经元的果蝇大脑,并将神经放电信号实时翻译成文字直接发送给ChatGPT,实现了生物神经信号与大语言模型的首次对话。
WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。