jina-ocr-v1:在低成本 GPU 上更快解析文档
jina-ocr-v1:在低成本 GPU 上更快解析文档Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
搜索
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
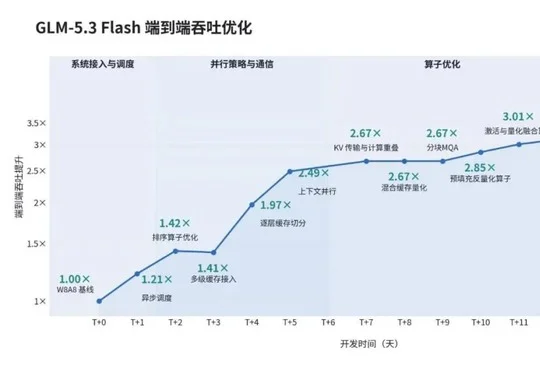
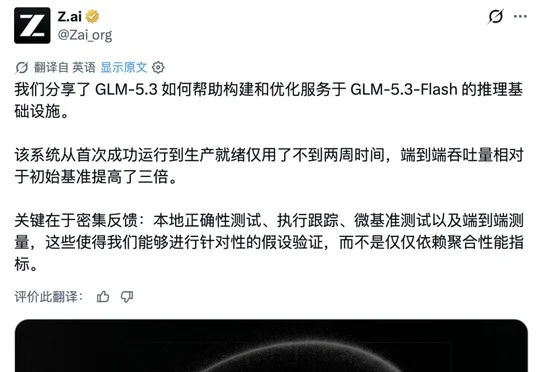
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。
清华姚班出身的彭天翼带队,Anthropic旗下Claude仅用11天、消耗60亿Token和1300万行代码,首次端到端形式化证明了困扰数学界350年的费马大定理,并产出29500条可验证中间定理,成为迄今为止最大的Lean证明。
看到形界智能「Era」系列的原生模型Rise正式发布了,用500ms的端到端响应延迟,让人机交互,有了新的变量。第一时间测试了一下,给大家介绍介绍。全域沉浸,一种全新的视频交互形态
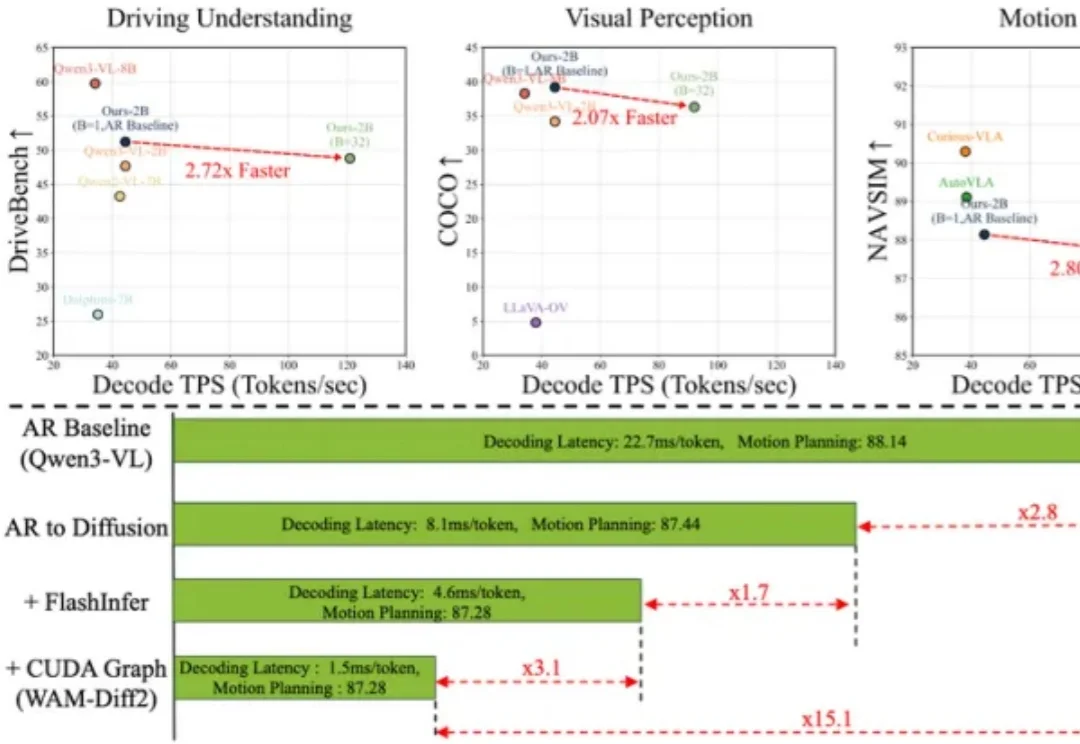
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。
端到端策略模型在物理世界频频失灵,研究者转向 “大模型智能体 + 工具调用” 自救,试图在动态物理世界中持续学习。然而,这条在线学习路径在物理世界仍未真正走通。
就在刚刚,OpenAI紧急叫停Astra!OpenAI内部评估显示,Astra在智能体编码和网络性能上取得的巨大突破,或已达到网络安全的「关键」阈值!这意味着,Astra可能具备自主开发零日漏洞,甚至仅凭高级指令发动新型端到端网络攻击的恐怖能力。